Yapay zeka akademik yayıncılığa musallat oldu
Küresel yapay zeka şirketlerinin dil modellerini eğitmek amacıyla Türkiye'deki yayınevlerinin arşivlerine yöneldiği iddiaları, yayıncılık sektöründe yeni bir tartışma başlattı.
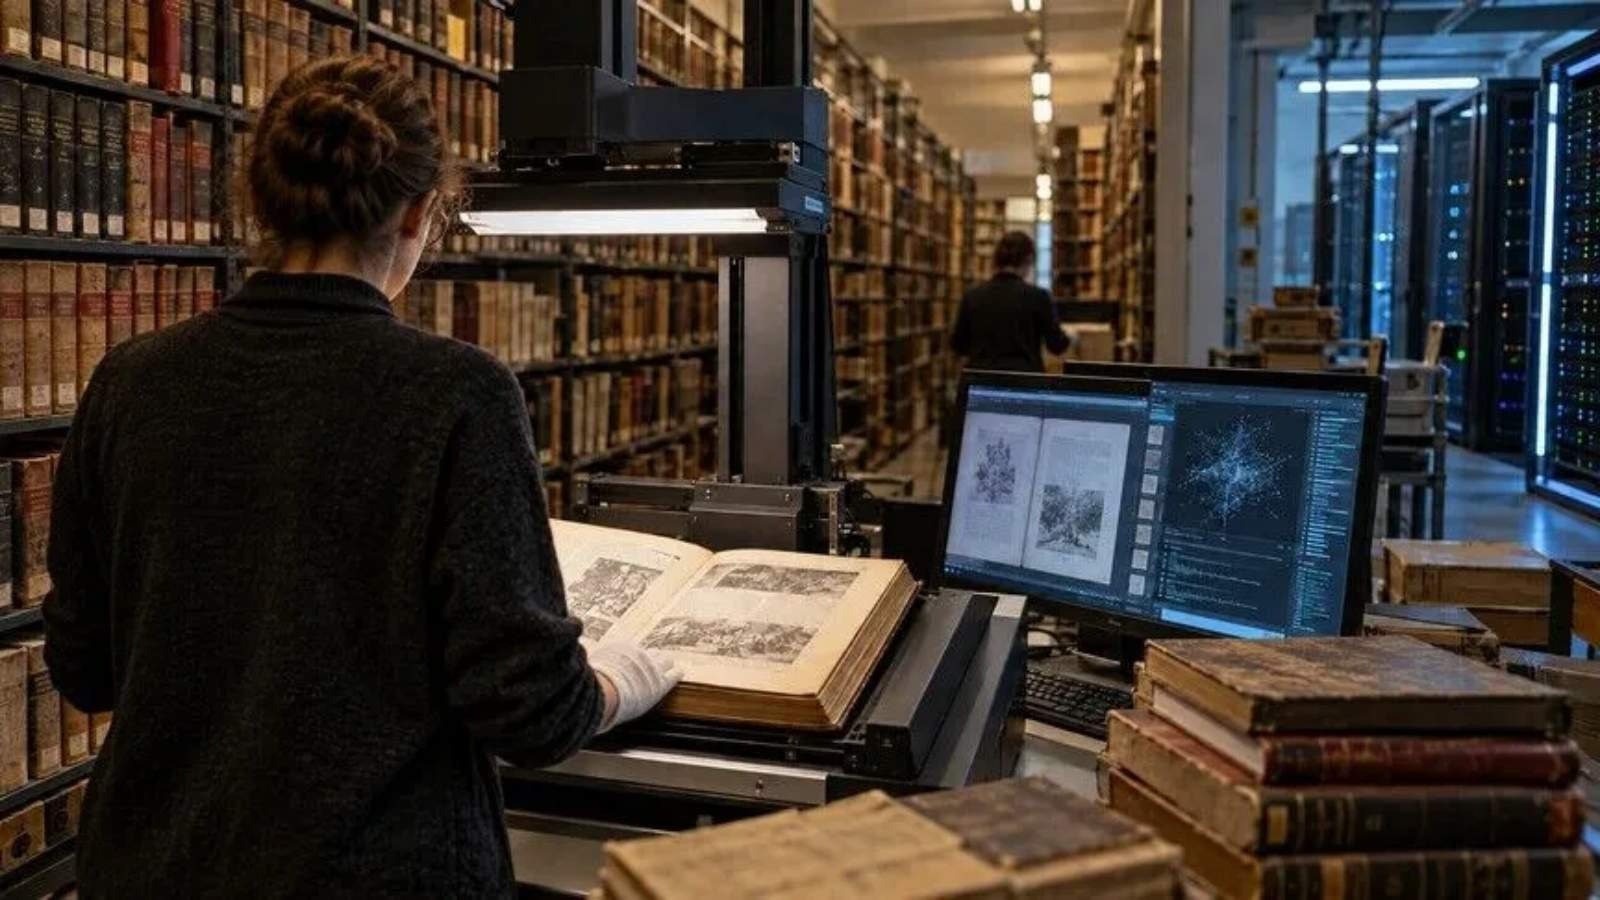
Anadolu Ajansı'nın (AA) "Yapay Zeka Şirketlerinin Kitap Avı" başlıklı özel dosyasında, küresel yapay zeka şirketlerinin Türkiye'deki kitap arşivlerine yönelik girişimleri, yayıncılar ve sektör temsilcileriyle masaya yatırılıyor.
Nobel Akademik Yayıncılık Genel Yayın Yönetmeni Nevzat Argun, AA'ya yaptığı açıklamalarda, yapay zeka şirketlerinin çeşitli aracı kurumlar üzerinden geniş kapsamlı akademik veri tabanlarını toplama faaliyetleri yürüttüğünü belirtti.
Bu girişimlerin, yayıncılık sektörü ve bilimsel bilgi üretimi üzerinde ciddi tehdit oluşturduğunu vurguladı. Son dönemlerde Türkçe kaynaklara olan talebin dikkat çekici şekilde arttığına işaret eden Argun, Nobel Akademik Yayıncılık’a da benzer bir talepte bulunulduğunu aktardı.
Argun, Hollanda merkezli bir şirket aracılığıyla 3 binden fazla Nobel kitabı ve diğer yayınevlerine ait birkaç bin kitabın tek tek sipariş edildiğini anlatarak şu sözlere yer verdi: "Başta her kitabın birer adetle sipariş edilmesi üzerine şüphelendik. Durumu inceledikten sonra bu taleplerin yapay zeka modellerinin eğitimiyle bağlantılı olduğuna kanaat getirerek tüm siparişleri iptal ettik. Bu alandaki tartışmayı başlatan adımlarımızdan biri de bu oldu."
Sürecin yalnızca fiziksel kitapların satın alınmasıyla sınırlı olmadığını belirten Argun, dijital içeriklerin de hedef alındığını söyledi. Dijital platformlarda kiralama yoluyla erişim sağlanan e-kitapların topluca satın alınması için teklifler sunulduğunu ifade etti.
YAPAY ZEKAYLA TEKELLEŞME ve SÖMÜRGECİ YAKLAŞIM ENDİŞESİ
Argun, piyasadaki nadir eserlerin dijitalleştirilmelerinin ardından fiziksel olarak yok edilmesi veya erişimlerinin kısıtlanması gibi iddialara da değindi. Yaşanan süreçleri küresel bir tekelleşme girişimi olarak değerlendirdi ve şu ifadeleri kullandı: "Aracı şirketler hangi ülkeden olurlarsa olsunlar, bu yapının arkasındaki asıl niyeti değiştirmiyor. Batı merkezli küresel sermaye, akademik yayıncılık alanında tekelleşmeye çalışıyor. Bu çerçevede Türkiye’den de bireysel olarak kitaplar toplanıp taranarak kendi sistemlerine dahil edilebilecekleri bir riskle karşı karşıyayız."
YAPAY ZEKA VERİSİ AÇIK ERİŞİM DEĞİL, KAYNAĞI BELİRSİZ BİR HARMAN
Kontrolsüz bir şekilde yapay zeka veri tabanlarına aktarılması muhtemel içeriklerin akademik geleneğe zarar verebileceğine dikkati çeken Argun, açık erişim ve yapay zeka modellerine içerik yüklenmesinin aynı şey olmadığının altını çizdi. "Akademik yayıncılık; denetlenebilirlik, hakem süreçleri, atıflar ve kaynakça gibi temel taşlar üzerine kurulu bir yapı. Açık erişimde araştırmacılar bu özelliklere uygun olarak materyallere ulaşır ve içerikten faydalanır. Ancak yapay zeka modellerinde bilgiler karışıyor; kaynağı, yazarı ve denetimi belli olmayan bir veri kütlesine dönüşüyor. Bu süreç, hem yazarların emeğini görünmez kılan hem de bilgi üretimini kısırlaştıran bir tehdit oluşturuyor" diye ekledi.
YAPAY ZEKANIN ÇEVİRİ HAFIZASINA YÖNELİK GİRİŞİMLERİ
Argun, küresel yapay zeka şirketlerinin sadece telifli içerikleri değil, aynı zamanda yayınevlerinin yıllar içinde oluşturduğu çeviri veri tabanlarına da ilgi gösterdiklerini söyledi. Üç yıl önce yaşanan bir örneği paylaşırken şunları dile getirdi: "Birlikte çalıştığımız bir yabancı yayınevi bizimle iletişime geçti. Türkçeye çevirdiğimiz eserlerin çeviri verilerini talep ederek yapay zekalarını geliştirmek istediklerini söylediler ve bunun karşılığında ödeme teklif ettiler. Bir süre sonra bu girişimden vazgeçtiler ancak burada amaçlarının ellerindeki orijinal metinleri farklı dillere hızla çevirip e-kitap formatında erişime sunmak olduğunu değerlendiriyoruz. Onların ellerinde mevcut bilgiler varken, bizim oluşturduğumuz çeviri hafızasına ihtiyaç duyuyorlardı."
Katkı sağlayanların hak ettiği payı adil şekilde aldığı bir modelin gerekliliğine dikkat çeken Argun, yapay zeka teknolojilerinin kaçınılmaz bir gelişim süreci içinde olduğunu vurguladı.
Ancak bu süreçte adil bir telif ve paylaşım ekosisteminin oluşturulmasının önemine de işaret etti. Mevcut telif sözleşmeleri ve yasal düzenlemelerin bu hızlı dönüşüme tam anlamıyla ayak uyduramadığını belirtti.
Argun, gelecekte yerel ya da etik değerlere uygun bir yapay zeka modeli geliştirilmesi durumunda, telif sahiplerinin haklarının korunmasının temel bir öncelik olması gerektiğini dile getirdi.
Açıklamalarını şu şekilde sürdürdü: Teknolojik olarak bu sistemleri inşa etmek aslında zor değil. Örneğin, 100 bin kitaplık bir veri tabanı oluşturuluyorsa, yapay zekanın verdiği yanıtlar sırasında bu eserlerden yapılan alıntılar veya kullanım oranlarına bağlı olarak yayıncıya ve yazara uygun paylar aktarılabilir. Dijital video platformlarında ya da arama motorlarında izlenme oranlarına göre içerik üreticilerine gelir paylaştırılması nasıl uygulanıyorsa, burada da katkı oranıyla orantılı şekilde pay alınacak adil bir mekanizma devreye sokulmalıdır.
Gercekedebiyat.com
Yorumlar
Bu içeriğe henüz yorum yapılmamış. İlk yorumu siz yazın.